摘要
维西县斜坡地质灾害频发,对当地基础设施、居民生命财产安全及区域经济发展构成了严重威胁。本文以维西县斜坡地质灾害为研究对象,筛选出坡度、地形起伏、工程地质岩组等因子,通过二元Logistic回归分析去除噪声因子,并基于 BP神经网络构建易发性预测模型。将维西县斜坡地质灾害易发区划分为高易发、中易发和低易发分区,其中高易发区面积 1322.38 km2 ,中易发区面积 1527.19 km2 ,低易发区面积 1624.43 km2 。结果显示,该模型预测精度较高,能精准反映区域间差异,具有较强的应用价值,为该县的防灾减灾工作提供了科学依据。
关键词
Abstract
The frequent occurrence of slope geological disasters in Weixi County poses a serious threat to local infrastructure, residents' life and property safety and regional economic development. In this paper, the slope geological disasters in Weixi County are taken as the research object, and the factors such as slope, topographic relief and engineering rock group are selected. The noise factors are removed by binary logistic regression analysis, and the susceptibility prediction model is constructed based on BP neural network. The susceptibility zoning of slope geological disasters in Weixi County is divided into high susceptibility, medium susceptibility and low susceptibility. The area of high susceptibility area is 1322.38 km2 , the area of medium susceptibility area is 1527.19 km2 , and the area of low susceptibility area is 1624.43 km2 . The results show that the model has high prediction accuracy, can accurately reflect regional differences, and has strong application value, which provides a scientific basis for disaster prevention and mitigation in the county.
0 引言
滑坡和崩塌斜坡类地质灾害,以其突发性、分布广泛性和毁灭性,直接威胁着人类的生命安全,并对基础设施比如房屋建筑、交通道路等造成了严重的破坏。斜坡地质灾害是维西县面临的重大地质灾害之一,给当地的经济社会发展带来了极大的挑战,影响了当地的生存环境及可持续发展能力。
传统的易发性评价方法主要分为定性和定量两大类。定性方法如层次分析法(Saaty,1980;康登成等,2024),主要基于经验总结和定性分析,难以准确反映灾害的复杂性和不确定性;定量方法如信息量法(范荣全等,2024;姜锡宸和刘桃,2024;于欢等,2025)、证据权法(杨华阳等,2020;冯振等, 2024)在处理多因素之间复杂的非线性关系时精度有限,难以精准刻画各因素与灾害易发性之间的内在联系。同时,这些方法在处理高维数据时存在局限性,评价结果精度受限,导致评价结果往往与实际情况存在一定偏差。
近年来,随着信息技术和统计学的快速发展,基于二元 Logistic 模型(Hosmer and Lemeshow, 2000;陈朝亮等,2019;李信等,2023;周萌等, 2024)、BP 神经网络模型(黄小龙等,2023;雷石等, 2024)、SVM 模型(Cortes and Vapnik,1995;何建华, 2023;翁彦梅等,2024)的灾害易发性评价方法逐渐受到重视。这两种方法能够充分考虑斜坡地质灾害形成过程中的多种因素,通过定量分析和模型构建,实现对斜坡地质灾害易发性的科学精细化评估。二元 Logistic 回归模型作为一种在二分类问题中广泛应用的统计模型,它能够通过剖析影响斜坡地质灾害发生的多种因素,构建起灾害发生概率与影响因素之间的线性关系,从而实现对地质灾害易发性的定量评估。而 BP 神经网络模型作为一种功能强大的机器学习方法,具备高度的非线性映射能力与自适应性,能够通过对大量历史灾害数据及相关因素的学习,构建精准的预测模型。
本文致力于将二元 logistic 回归模型与 BP 神经网络模型进行耦合,并应用于维西县斜坡地质灾害易发性评价之中。通过充分整合二元 logistic 回归模型对变量逻辑关系的有效表达,以及BP神经网络模型强大的非线性映射能力,构建更为精准、可靠的地质灾害易发性评价模型,进而为维西县地质灾害防治和国土空间利用提供更加科学、有效的决策支持。
1 研究区概况
1.1 自然地质概况
维西县位于云南省迪庆藏族自治州,地处东经 98°54'~99°34',北纬26°53'~28°02'(周丹等,2014)。维西县地质构造复杂,境内分布有多条断层,其活动对周边岩土体稳定性产生了较大影响,破坏了地层的完整性,增加了斜坡失稳的风险。地层岩性多样,出露有花岗岩、砂岩、页岩以及各类变质岩等,不同岩石的物理力学性质差异明显,其中页岩等软弱岩石组成的斜坡在外部因素作用下更易发生变形破坏。在地形地貌方面,维西县以山地、丘陵为主,河谷深切,地势起伏较大,坡度普遍较陡,这种地形条件使得斜坡在重力作用下具备较高的势能,一旦岩土体稳定性受到破坏,极易引发滑坡、崩塌等地质灾害。
1.2 地质灾害概况
根据云南省最新开展的地质灾害精细化调查与风险评价工作(陈荣彦等,2024),区内共发育斜坡类地质灾害 541 处,其中滑坡 384 处、崩塌 157 处 (图1)。按灾害规模可划分为大型、中型及小型 3类,其中,小型滑坡 216处,中型滑坡 147处,大型滑坡 21 处;小型崩塌 67 处,中型崩塌 76 处,大型崩塌 14处。

图1研究区概况
2 评价因子
根据斜坡地质灾害发育的相关特征及维西县精细化调查成果,通过分析维西县地质灾害的孕灾条件、发育和分布所呈现的规律,筛选坡度、地形起伏、斜坡结构、工程地质岩组、与断层距离、与水系距离、土地利用、平面曲率、剖面曲率、坡向、地貌、 NDVI共12类因子作为斜坡地质灾害易发性的评价因子。数字模型栅格尺寸采用25 m×25 m。
坡度:是衡量斜坡稳定性的关键指标之一,在自然条件下,斜坡坡度与其承受的剪应力成正比关系,坡度越大其承受的剪应力越大,同时斜坡地质灾害发生的概率越大。利用ArcGIS软件,基于DEM 数据提取维西县坡度,并将其划分为<15°、15°~25°、25°~35°、35°~45°、>45°共5级,其空间分布情况如图2a所示。
地形起伏:维西县海拔范围为 1980~4982 m,地形高差较为显著。利用 ArcGIS 软件,以 DEM 数据为基础数据源,通过调查分析,将维西县的地形起伏分为4个级别,即微起伏(0~20 m)、小起伏(20~75 m)、中起伏(75~200 m)、大起伏(>200 m),其空间分布特征如图2b所示。
斜坡结构:综合考虑斜坡岩土体的物理力学性质,然后结合坡度的陡缓、坡向的朝向以及与岩层倾角大小和倾向方向等要素之间的相互关系,将维西县的斜坡结构分为土质斜坡、块状岩体、顺斜坡、逆斜坡、横向坡、顺向坡及逆向坡共 7 级,其空间分布特征如图2c所示。
工程地质岩组:对维西县的岩组进行研究时,综合考虑岩性组合方式比如软硬及抗风化能力,结合该地区地质灾害的发育特征,在此基础上将维西县的岩组归并为 7 大类,分别为:松散岩类岩组、软弱层状碎屑岩岩组、软硬相间层状碎屑岩岩组、较硬—较软层状碎屑岩岩组、变质岩岩组、碳酸盐岩岩组、岩浆岩岩组,其空间分布特征如图2d所示。
距断层的距离:断层的规模大小及断裂带宽度的大小直接影响断层周边的结构复杂性,本文选择的深大断裂及其他活动断裂,从区域资料及调查结果上看,影响范围多在 1 km 以内,将与断层的距离划分为 <200 m、200~500 m、500~1000 m、1000~2000 m、>2000 m 共 5 级,其空间分布情况如图2e所示。
距水系的距离:水系对两岸岩土体的冲刷和侵蚀作用是破坏斜坡稳定性的重要因素之一。此外,河流两岸及其冲积、洪积形成的平原地区,由于自然条件相对优越,适宜人类居住和生产活动,人类工程活动较为频繁,进而影响了地质灾害发生的概率。利用维西县的水系网地理数据,提取距水系0~300 m、300~600 m、600~900 m、900~1200 m、1200~1500 m、>1500 m 的缓冲区范围,其空间分布情况如图2f所示。
土地利用:人类活动的强度和方式不同会造成土地利用类型的差异,这些差异会进一步改变地质环境进而又会对地质灾害的发生产生不同程度的影响。在维西县,根据主要的土地利用类型,将其划分为草地、林地、耕地、居民地、工矿用地、裸地及其他用地共 7 类,不同土地利用类型的空间分布情况如图2g所示。
平面曲率:平面曲率反映了斜坡表面的弯曲变化情况,对地表水的流动和汇集有着重要影响。在曲率较大的区域,地表水容易汇聚,增加了斜坡岩土体的含水量,从而降低了岩土体的抗剪强度,提高了地质灾害发生的可能性。利用ArcGIS软件,基于DEM数据提取维西县的平面曲率,该工具对二阶导数计算结果乘以 100 放大输出,故数值单位为 0.01 m-1,并将其划分为<-0.5×0.01 m-1、-0.5×0.01 m-1~0、0~0.5×0.01 m-1、>0.5×0.01 m-1 共4个等级(图2h)。
图2评价因子图
a—坡度;b—地形起伏;c—斜坡结构;d—工程地质岩组;e—与断层距离;f—与水系距离;g—土地利用;h—平面曲率;i—剖面曲率;j—坡向; k—地貌;l—NDVI
剖面曲率:剖面曲率是反映斜坡在垂直方向上的弯曲变化情况,对地表水的流速和侵蚀能力有显著影响。斜坡的剖面曲率越大,坡面径流速度越快,同时侵蚀作用也越大,更容易导致斜坡上岩土体的流失和松动,使地质灾害的发生概率增大。基于 DEM数据,利用ArcGIS软件提取维西县的剖面曲率,数值单位同平面曲率,将其划分为<-0.5×0.01 m-1、-0.5×0.01 m-1~0、0~0.5×0.01 m-1、>0.5×0.01 m-1 共 4 个等级(图2i)。
坡向:坡向不同,太阳照射的时长、降水量的大小以及风化程度等也会有所差异,从而影响着斜坡岩土体的物理力学性质和稳定性。例如,阳坡由于接受的太阳辐射较多,温度较高,风化作用相对较强,岩土体较为松散;而阴坡则相对较为稳定。利用 ArcGIS 软件,基于 DEM 数据提取维西县的坡向,将其划分为平面(-1),北坡(337.5°~22.5°)、东北坡 (22.5°~67.5°)、东坡(67.5°~112.5°)、东南坡(112.5°~157.5°)、南坡(157.5°~202.5°)、西南坡(202.5°~247.5°)、西坡(247.5°~292.5°)、西北坡(292.5°~337.5°)共9个方向(图2j)。
地貌:维西县的地貌类型多样,不同的地貌单元具有不同的地形特征、岩土体组成和地质构造背景,这些因素综合影响着地质灾害的发生和分布。根据地质调查和相关资料,维西县地貌类型划分为以下6类:构造侵蚀地貌区,构造侵蚀、溶蚀地貌区,构造剥蚀地貌区,岩溶地貌,堆积地貌,冰川地貌,具体划分情况如图2k所示。
植被指数(NDVI):能够反映植被的生长状况和覆盖程度。植被具有保持水土、调节径流等作用,植被覆盖度越高,对岩土体的保护作用越强,发生地质灾害的可能性就越小。利用维西县遥感数据,计算得到维西县的NDVI数值,并将其划分为<0.2、 0.2~0.4、0.4~0.6、0.6~0.8、0.8~1共5级(图2l)。
3 研究方法
本研究采用的技术路线是利用二元 logistic 回归分析去除噪声因子,然后耦合BP神经网络得到不同评价因子下的预测概率值,然后利用ROC曲线验证其预测结果,并绘制基于二元logistic回归耦合BP 神经网络模型的地质灾害精细化易发性图。该方法主要包含以下几个关键步骤:数据收集、去除噪声因子、模型验证与选择、斜坡地质灾害易发性评价,具体流程如图3所示。
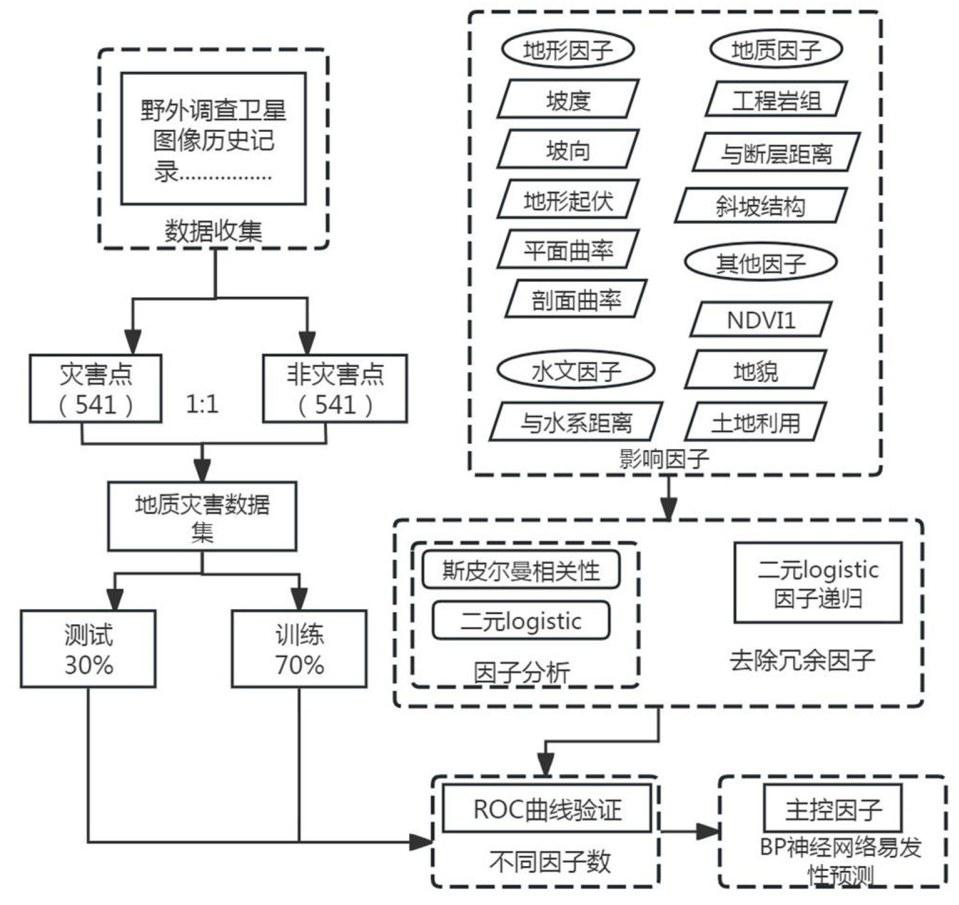
图3技术路线
3.1 二元logistic回归模型
二元 Logistic 回归是一种用于分析自变量与二元因变量之间关系的统计方法。常用于预测事件发生的概率。
假设存在 n 个自变量 x1,x2,,xn构建一个线性组合
(1)
式(1)中β0是截距,βi(i=1,2,,n)是回归系数。这些系数决定了每个自变量对因变量的影响程度和方向。
由于线性组合z的取值范围是(-∞,+∞),而概率的取值范围是[0,1],所以需要使用 Logistic 函数(也称为Sigmoid函数)将z转换为概率P,这样就得到了给定自变量条件下,因变量取 1的概率。Logistic 函数的表达式为
(2)
依据回归系数的显著性检验(如 Wald 检验)结果,P 值大于设定显著性水平 0.05 的自变量可能为噪声因子。
3.2 BP神经网络模型
BP 神经网络(Back-Propagation Neural Network),即反向传播神经网络,是一种多层前馈神经网络。它可以对任意复杂的非线性关系进行建模 (图4)。
其网络结构主要分为:
输入层:是神经网络与外部数据交互的起始部分,承担着接收外部输入数据的任务,神经元的数量取决于输入数据的特征数量。
隐藏层:可以有一层或多层,隐藏层神经元通过加权连接接收输入层或前一层的输出,并进行非线性变换。隐藏层的存在使神经网络能够学习到数据中的复杂特征和模式。
输出层:是神经网络处理数据的最终环节,其主要功能是产生最终的输出结果。输出层中神经元的数量根据具体任务确定,例如,在解决二分类问题时,输出层通常只设置1个神经元,通过该神经元输出的结果(如0或1)来判断数据属于哪一类。
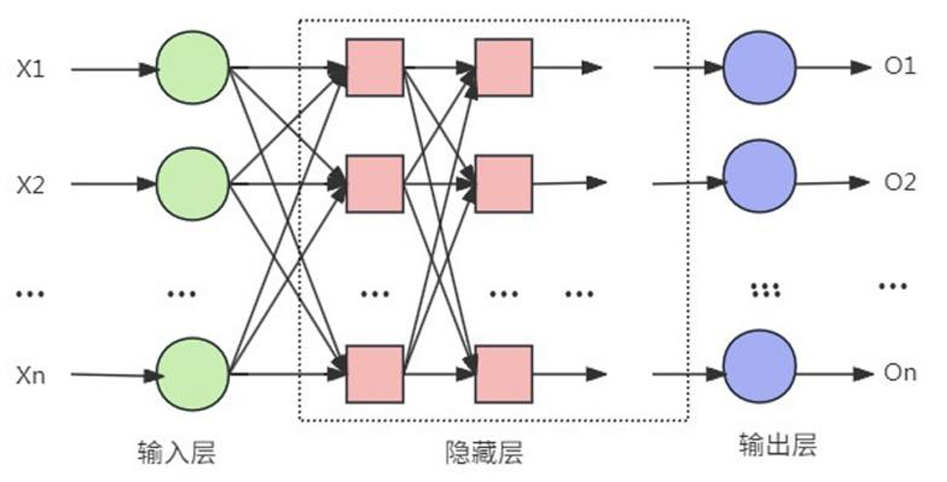
图4BP模型示意图
3.3 耦合模型
将预处理后的数据输入二元Logistic回归模型,计算每个自变量的回归系数、P 值和优势比等评价指标。剔除 P 值大于 0.05 的自变量,同时结合优势比,去除效应值过小的自变量。经过筛选后的自变量作为BP神经网络的输入层神经元。
在构建BP神经网络模型时,首先利用上面确定的自变量来精准确定输入层神经元的个数。然后通过严谨的试验来确定隐藏层神经元个数以及隐藏层数。再次将经 Logistic 回归筛选后的数据集划分为训练集、测试集两个部分。利用BP神经网络模型对训练集开展训练工作,在整个训练进程中,持续不断地对网络的权重和阈值进行优化调整,尽可能降低模型在训练集上的误差值;在训练期间,对模型的性能进行实时监测,通过观察误差变化及模型的预测效果,及时发现并避免出现过拟合现象。最后当模型训练完成后,采用准确率、召回率、F1值以及ROC曲线等评估指标,使用测试集来全面评估训练好的BP神经网络模型的性能。
4 结果与分析
4.1 筛选因子
Spearman 相关系数分析是一种衡量变量间相关性的有效方法,与变量的分布形式无关,能够直接揭示因子之间的单调关系。通过 Python 中的函数来对12个因子进行Spearman相关性分析,并绘制出评价因子相关性分析热力图(图5)。
通过图5结果显示,坡度与地形起伏的相关系数高达 0.73,原因在于坡度与地形起伏同属于地形因子,地形起伏变化剧烈的区域,坡度往往也较大,二者紧密关联。在实际地质环境中,地形起伏大意味着高差变化显著,这种地形条件下斜坡所受重力作用复杂,而坡度直接影响重力沿坡面的分力大小,进而共同影响斜坡稳定性。基于对地形因素在地质灾害发生过程中作用机制的理解,结合以往研究经验,坡度在反映地形对地质灾害影响方面更为直接和关键,故保留坡度因子。

图5评价因子相关性分析热力图
a—坡度;b—地形起伏;c—斜坡结构;d—工程地质岩组;e—断层距离;f—水系距离;g—土地利用;h—平面曲率;i—剖面曲率;j—坡向; k—地貌;l—NDVI
同时,剖面曲率与平面曲率同属曲率指标,其相关性系数高达0.85。平面曲率主要描述地形在水平面上的弯曲程度,它影响着坡面径流的汇聚与分散,进而改变岩土体的受力状态;剖面曲率则反映地形在垂直面上的弯曲特征,二者从不同角度反映地形对地质灾害的影响。但考虑到平面曲率在描述地形表面凹凸变化对地质灾害发生的影响上更具代表性,且与其他因子的信息冗余度相对较低,基于经验选择保留平面曲率,剔除剖面曲率。
此外,利用二元logistic回归模型对12个因子进行分析。在该模型中,将是否发生过灾害作为因变量,采用 0 和 1 分别代表未发生和发生过灾害。已知维西县斜坡类地质灾害点为 541 处,为保证分析结果的可靠性和代表性,按照灾害点 1.5 km 以外随机生成相应的 541处非灾害点,构建总计 1082处点的因变量数据。
通过二元 logistic 回归分析,利用 Python 语言计算得到二元 logistic 结果(表1)。从表1中数据可知,地形起伏、剖面曲率、坡向、地貌的 P 值均大于 0.05。在统计学中,P值大于设定显著性水平,表明这些自变量在当前模型中对地质灾害发生的影响并不显著,即这些因素的变化并不能有效解释地质灾害发生与否的差异,因此需要将其从后续分析中剔除。而其他因子的 P 值小于 0.05,说明它们对地质灾害的发生具有显著影响。
表1二元logistic结果分析

以土地利用和 NDVI 为例,土地利用的优势比为 0.86。优势比反映了自变量每变化一个单位,事件发生的概率变化情况。土地利用优势比小于 1,说明土地利用现状从工矿用地、居民地到裸土地、草地随着地类的变化地质灾害发生的概率在变小,这与实际情况相符。这是因为不同土地利用类型下,人类活动强度和对地表的影响程度不一样。草地和裸土地人类活动相对较少,地表能够保持原始的自然状态,岩土体稳定性受干扰较小;而工矿用地和居民地人类工程活动频繁,如大规模建设、开挖等,改变了原有的地形地貌和岩土体结构,增加了地质灾害发生的风险。NDVI的优势比为0.65,表明随着植被指数升高,植被覆盖度越好,地质灾害发生得越少,这与实际情况相符。
综合上述分析,最终剔除地形起伏、剖面曲率、坡向、地貌4个因子,保留坡度、斜坡结构、工程地质岩组、与断层距离、与水系距离、土地利用、平面曲率、NDVI共8个因子作为主控因子。
4.2 递归分析与效果验证
基于 Python 语言建立二元 logistic 训练模型,依次代入 12 因子进行递归分析,计算不同因子下的 AUC值,通过AUC值对模型在不同因子组合下的预测准确性进行量化评价,引入混淆矩阵,以敏感度为纵坐标,特异性为横坐标绘制曲线,验证模型在不同评价因子下的预测准确性(龚俊豪等,2024)。 AUC值是衡量模型性能的重要指标,其取值范围在 0 到 1 之间,AUC 值越接近 1,说明模型的预测准确性越高。
从验证结果(图6)可以看出,当仅有坡度一个因子时,AUC值仅为0.55,这表明单一因子对地质灾害易发性的预测能力极为有限,难以全面反映地质灾害发生的复杂机制。随着因子数量逐渐增加, AUC 值呈现上升趋势,当代入因子为 12 个时,AUC 的值达到最大值 0.82。然而,在逐步代入因子的过程中发现,当代入第9个因子剖面曲率时,AUC值从0.81 降为 0.80;代入第 11 个因子地貌时,AUC 值与代入第10个因子时无变化。这一现象表明,剖面曲率和地貌因子在当前模型中对预测精度的提升作用不明显,甚至可能引入一定的干扰信息,影响模型的准确性。

图612个因子不同因子数时的ROC曲线
a—1个因子;b—2个因子;c—3个因子;d—4个因子;e—5个因子;f—6个因子;g—7个因子;h—8个因子;i—9个因子;j—10个因子;k—11个因子;l—12个因子
为进一步明确最优因子组合,基于保留的 8 个主控因子进行递归分析,并绘制ROC曲线(图7),通过观察,从 1个因子到 8个因子逐步增加的过程中, AUC 值从 0.55 逐渐升高到 0.81。这清晰地表明,随着因子数量的增加,模型能够捕捉到更多与地质灾害易发性相关的信息,从而不断提高预测准确率。当因子数量为8时,AUC值达到最高,意味着此时模型能够最有效地综合各因子信息,对地质灾害易发性做出最精准的预测,模型性能达到最佳状态。因此最终确定坡度、斜坡结构、工程地质岩组、与断层距离、与水系距离、土地利用、平面曲率、NDVI作为维西县斜坡地质灾害的主控因子,代入BP神经网络进行计算。

图78个因子不同因子数时的ROC曲线
a—1个因子;b—2个因子;c—3个因子;d—4个因子;e—5个因子;f—6个因子;g—7个因子;h—8个因子
4.3 基于BP神经网络的易发性评价
将最终保留的因子首先进行数据预处理,包括数据清洗、数据归一化等。将1082处点数据进行划分,按照 70%的训练集,30%的测试集进行划分,划分过程采用随机划分,确保训练集和测试集的数据分布能够代表整体数据特征,同时保证随机性以避免数据偏倚对模型训练和评估产生影响。
BP 神经网络结构中的输入层为地质灾害因子的数量,即本研究确定的 8 个主控因子对应 8 个输入层神经元。隐藏层节点数量对模型的学习能力和泛化能力具有决定性影响。隐藏层节点数量过少,难以充分学习数据中的复杂特征和规律,导致拟合程度不够;隐藏层节点数量过多,则可能使模型学习到过多的噪声和细节,出现过拟合现象,使模型面对新的、未见过的数据时,模型的泛化能力降低,导致预测结果不准确。因此,在初步确定隐藏层节点数量的大致范围后,进行了多次试验,分别设置隐藏层节点数量为 3、5、8、10、12、15 等不同取值。利用 Python 对比取值下模型在验证集上的性能,最终选择隐藏层节点为 10。此时,模型在验证集上的准确率、召回率等指标综合表现最佳,能够在学习数据特征的同时,保持较好的泛化能力。
由于本研究数据量比较大,选择优化权重的求解器为 adam。adam 求解器基于自适应矩阵估计算法,能够自适应地调整学习率,适应大规模数据的训练。同时制定 max_iter 值,保证如果在达到最大迭代次数之前,模型的损失函数没有收敛训练自动停止。输出层的结果为每个训练集的易发性指数,该指数反映了相应区域发生地质灾害的可能性大小。
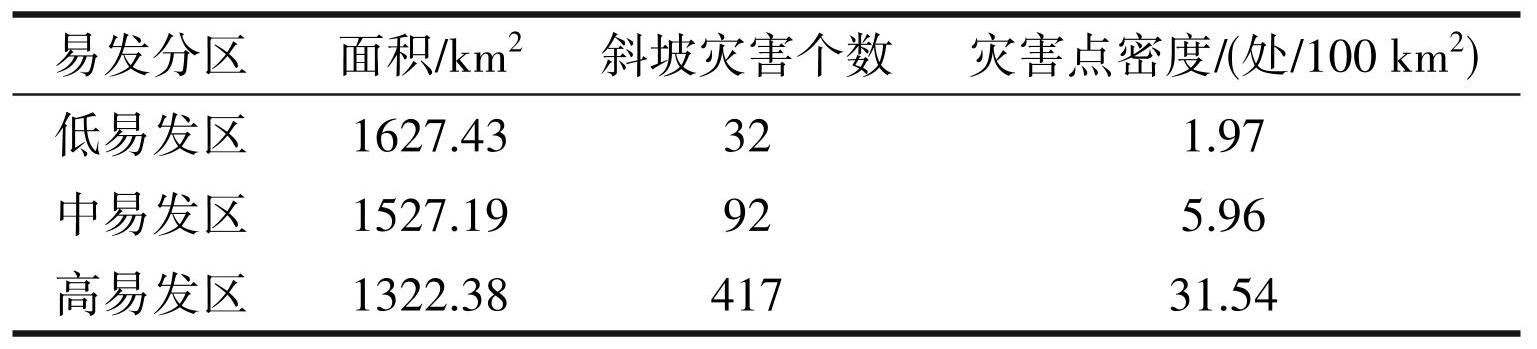
本文的评价单元划分采用规则单元法(尹展等,2024),采用25 m×25 m的网格作为评价单元,全县共划分为7144450个网格。基于Python与ArcPy,利用搭建好的 BP 神经网络模型对维西县全县范围的 7144450 个栅格进行预测,得到维西县斜坡地质灾害的易发性评价指数结果(图8a)。将计算的易发性评价指数导入到ArcGIS中,利用ArcGIS的自然间断法将易发分区划分为高、中、低 3 个等级,得到易发性分区图(图8b)和易发性分区信息表(表2)。从图8b可以看出,高易发区、中易发区和低易发区在空间上呈现出明显的分布规律,与维西县的地质构造、地形地貌、土地利用等实际情况相吻合,初步验证了模型的有效性。

图8易发评价指数图(a)及分区图(b)
表2易发性分区统计
4.4 模型精度分析
4.4.1 精度统计分析
灾害点密度是衡量某一易发等级区内斜坡地质灾害强度的重要指标,它通过某一易发等级区内斜坡地质灾害个数与其易发区面积的比值来计算。从理论上讲,灾害点密度越大,意味着该区域发生地质灾害的概率越高,易发等级越高。同时,高易发区与低易发区的灾害点密度差值越大,说明模型对不同易发区域的区分能力越强,模型能够更准确地反映地质灾害在不同区域的分布差异,其性能也就越好。
由表2数据可知,维西县斜坡地质灾害易发分区的灾害点密度统计符合上述原则,说明BP神经网络模型性能很好。同时,通过表2可以看出高易发区的灾害点密度高达 31.54处/100 km2,这个结果与野外实地调查情况吻合性非常好,通过实地调查发现,高易发区确实存在较多的地质灾害隐患点,且历史上发生地质灾害的频率较高。这进一步验证了模型的可靠性。
4.4.2 模型预测能力分析
模型的预测能力评判需要综合考虑多个指标,本研究采用的指标体系中包含了准确率、召回率、精准率、F1 值、重要特征值和 ROC 曲线。这些指标从不同角度对模型的预测性能进行评估,能够全面、准确地反应模型的优劣。
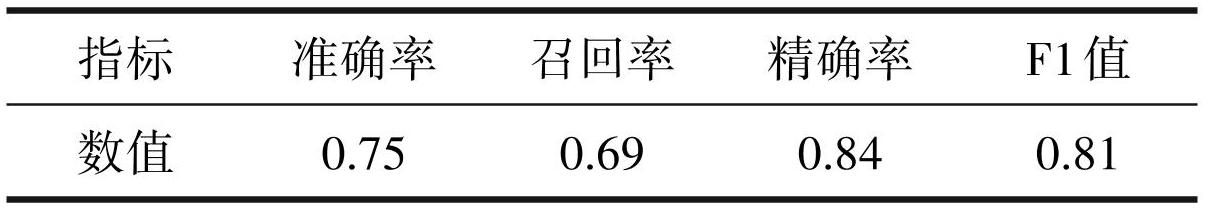
评判的标准是计算的数值越高代表模型的预测性能越好。BP神经网络模型计算的准确率、召回率、精准率、F1值如表3所示,通过分析表格可以看出,BP神经网络模型整体预测性能较好。
表3模型评价指标
重要特征值是衡量哪些因素对模型输出结果具有显著的影响;数值为负表明该特征对模型的预测结果有反向的作用,数值为零说明该特征在当前的BP神经网络模型中对预测结果几乎没有影响,数值为正表明该特征对模型的预测结果有正向的贡献,数值越大贡献越大。本研究的重要特征结果 (图9),表明所选的 8 个因子对于本文 BP 神经网络模型的预测结果具有正向贡献。其中,坡度、工程地质岩组、与断层距离等因子的重要特征值相对较大,说明这些因子在模型预测地质灾害易发性过程中发挥了更为关键的作用,对模型输出结果的影响更为显著。这与地质灾害形成的理论和实际情况相符,进一步验证了因子选择的合理性和模型的有效性。
BP神经网络用于二分类预测时,ROC曲线是一个全面评估模型性能的重要指标,ROC曲线不受样本类别分布的影响,能客观地反映模型在不同阈值下的分类性能。本次BP神经网络模型的ROC曲线 (图10)显示 AUC 值为 0.87。在 ROC 曲线评价体系中,AUC值大于 0.7表示模型具有较好的预测效果, AUC 值越接近 1,模型的预测性能越好。本模型 AUC 值达到 0.87,说明其在预测维西县斜坡地质灾害易发性方面具有较高的准确性和可靠性。
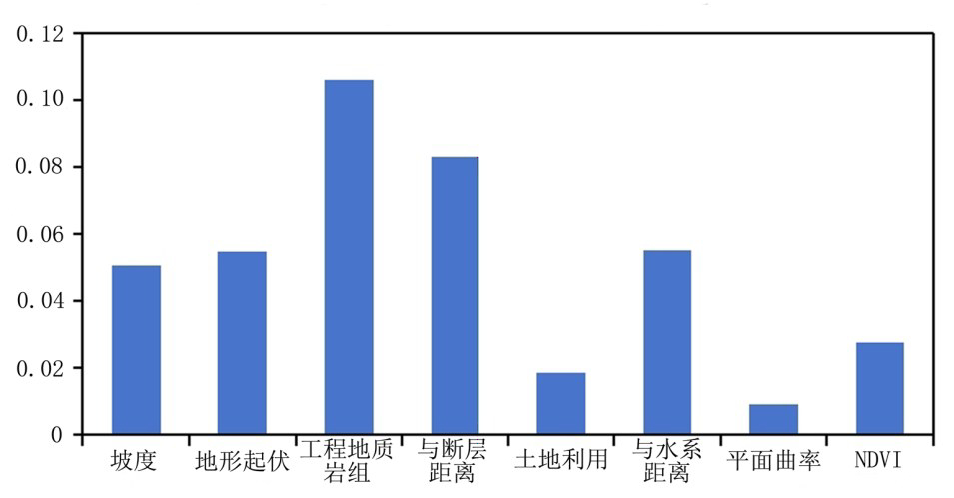
图9重要特征值
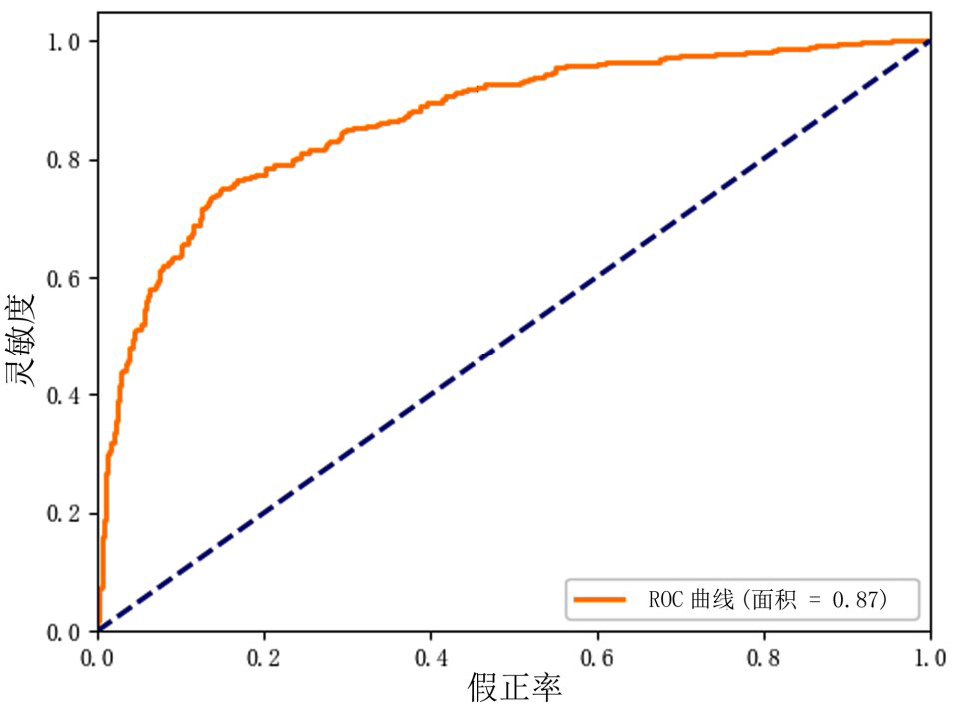
图10模型的ROC曲线
5 结论
通过对云南省维西县斜坡地质灾害进行基于二元 logistic 与 BP 神经网络耦合模型的易发性评价,可以得到以下结论:
(1)通过二元 Logistic 回归分析,结合 P 值显著性水平(0.05),最终筛选出 8 个关键因子,包括坡度、斜坡结构、工程地质岩组、与断层距离、与水系距离、土地利用、平面曲率、NDVI。剔除的地形起伏、剖面曲率、坡向、地貌因子P值均大于0.05,表明其对地质灾害发生的影响较弱,或与其他因子存在较强的相关性(相关性系数>0.7)。本研究优先保留对预测精度贡献度较高的因子,以提高模型的稳定性。经筛选确定的这8个因子在模型预测中表现出更高的准确性,能够更有效地反应地质灾害易发性与各影响因素之间的关系。这一结果不仅为维西县地质灾害研究提供了关键的影响因素指标,也为后续其他地区的地质灾害易发性评价提供了有益的思路参考。
(2)通过准确率、召回率、精准率、F1值、重要特征值和 ROC 曲线等评价指标的验证和比较,表明 Logistic-BP 耦合模型在维西县斜坡地质灾害易发性评价中的效果显著。该模型能够充分发挥二元 logistic 回归模型筛选关键因子和 BP 神经网络模型处理非线性关系的优势,使得评价结果的分区更加精确,能够更准确地反映不同区域的地质灾害易发性差异。
(3)BP 神经网络模型的 AUC 的值为 0.87,远远大于 0.7,表明模型的评价结果具有较高的可靠性。并且通过与野外调查结果对照,发现易发分区的吻合度相当高。这进一步验证了本研究构建的模型能够真实地反映维西县斜坡地质灾害的实际情况。在未来的研究和实践中,进一步优化模型,结合更多的实时监测数据,提高地质灾害易发性评价的精度和时效性。同时,应强化地质灾害高易发区防治,构建实时监测预警系统,并在国土空间规划中,避免在高易发区进行大规模开发建设,切实降低地质灾害风险。
6 讨论
尽管本研究构建的 Logistic-BP 耦合模型在维西县斜坡地质灾害易发性评价中表现良好,但仍存在一定局限性。首先,本研究在因子选择上主要基于地质、地理数据等,未纳入实时降雨、地震等外部触发因子,因此在短期预测中的适用性尚需进一步验证。其次,BP神经网络在训练过程中对数据的规模和质量较为敏感,当数据量不足或者数据质量不高时,可能会导致模型的预测精度降低;未来可尝试引入集成学习或深度学习方法,以进一步提升预测精度和泛化能力,不断的完善地质灾害易发性评价模型。
